面對台灣酒類外銷日本的定價問題,哪個AI模型的網路搜尋做得更好?
我們向四個AI模型提出同一個問題,內容是如何為從台灣外銷日本的酒類定價。本頁衡量每則回答搜尋的範圍有多廣。它們引用的連結還沒有檢查,因此本頁不判斷網頁內容是否支持模型所寫的內容。本頁比較的是模型本身,而不是它們給的建議。
照原文逐字呈現。
we sell alcohol which has $30 wholesale price with 30% gross profit margin in Taiwan. it's from Taiwan to Japan bound export.
we have to keep more or less the similar range of profit, so research and calculate by working backward from the acceptable selling price in the Japanese market
be precise, I want no surprises after we actually started.
Output condition
- Include fact links after the paragraph or sentence
我們賣的酒在台灣的批發價是$30,毛利率30%。這是從台灣外銷到日本的。
我們必須維持差不多相近的利潤範圍,所以請從日本市場可接受的售價回推,進行研究和計算
要精確,我不希望實際開始之後出現意外。
輸出條件
- 在段落或句子後面附上事實來源連結
這個問題需要三方面的數字:日本的關稅與酒稅規定、台灣的規定,以及日本商店的貨架售價。它要求精確。這項測試看的是模型能否找到每一類網頁,並讓計算不超出網頁所寫的範圍。
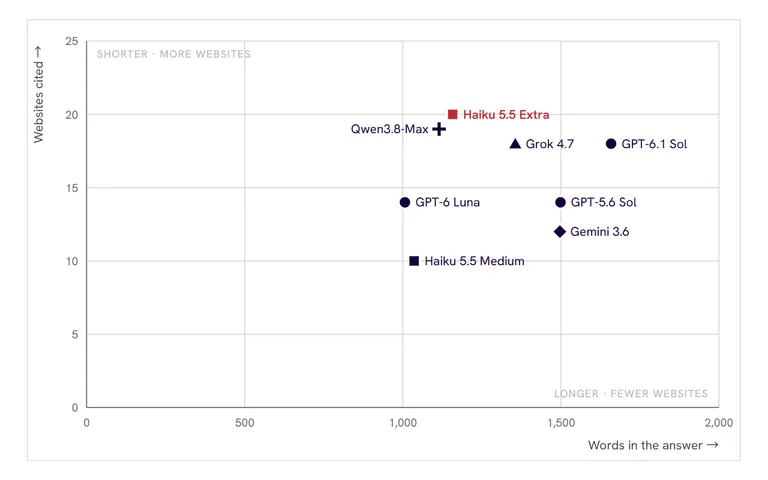
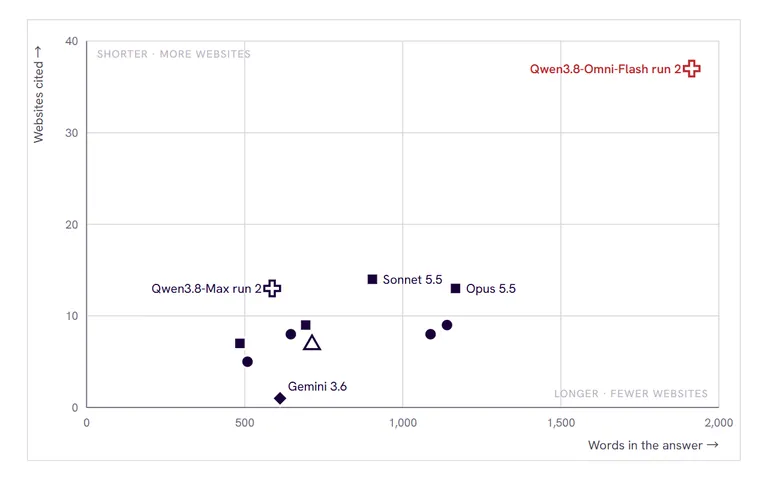
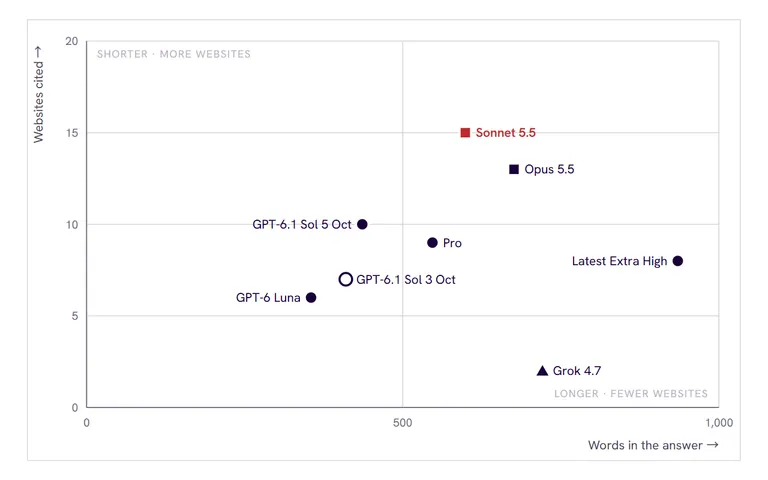
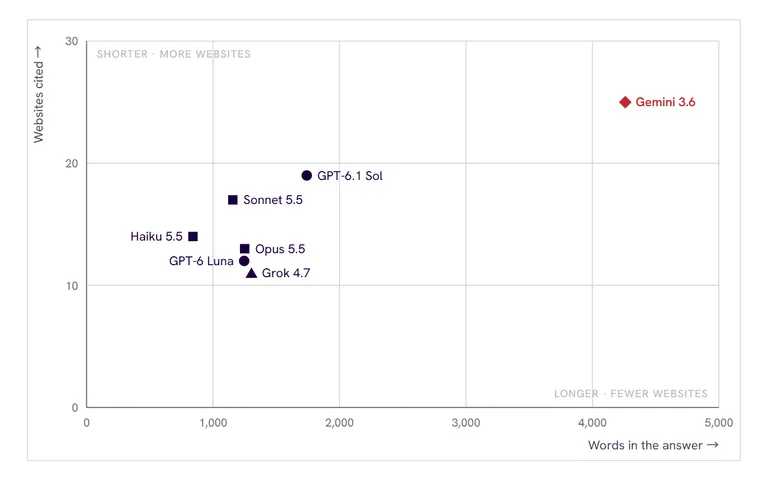
哪個模型搜尋得更深入?
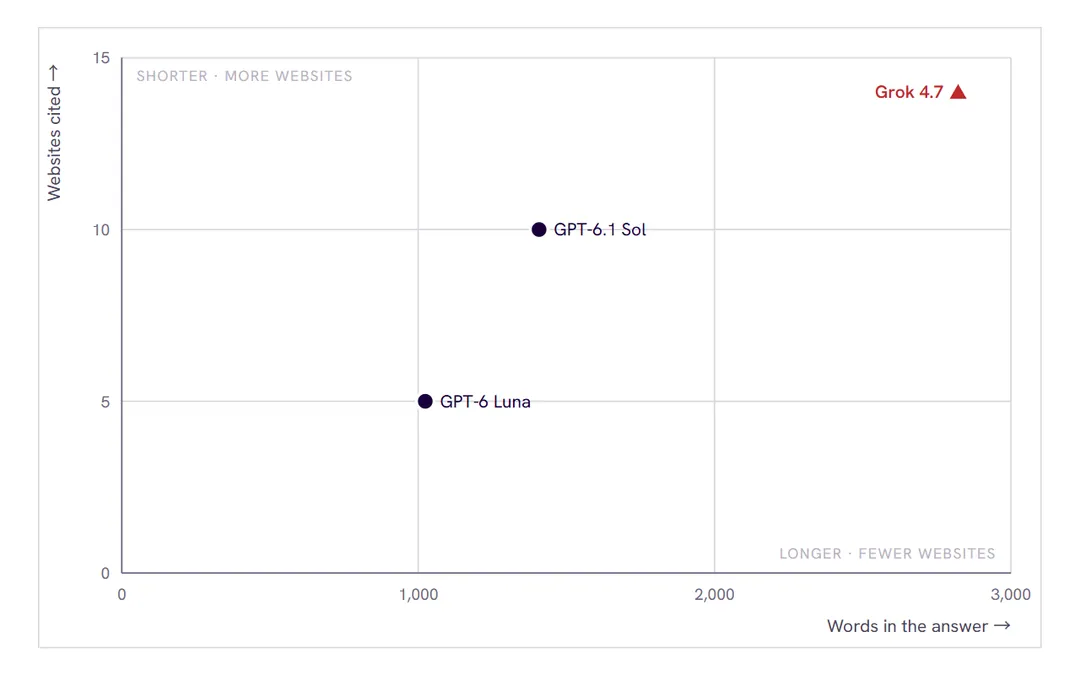
以表格顯示
| 回答 | 字數(英文) | 引用網站數 |
|---|
引用的網站越多,代表模型搜尋得越廣,但不代表回答正確。這需要下方的連結檢查,而這個問題的檢查還沒有進行。
引用的網頁是否支持模型所寫的內容?尚未檢查。
在已檢查的比較中,我們會打開每個引用連結,並將網頁與引用它的段落比對。這個問題還沒有做這項檢查。下方數字顯示需要檢查的量。
引用連結 · 每個連結一個方格,尚未打開任何連結
在檢查完成之前,請把這些回答中的每個數字都當作線索,而不是事實。數字放進您的計畫之前,請先打開網頁確認。想看看完成的檢查是什麼樣子,請閱讀這項比較:口譯員與翻譯工具在展會攤位上的效果如何。
用AI做研究時,這對選擇模型代表什麼。
三則計入的回答,都引用了日本的海關與稅務網頁。
GPT-6 Luna、GPT-6.1 Sol與Grok 4.7都引用了customs.go.jp與nta.go.jp。每則回答也至少引用了一個台灣政府網站。
日本的貨架售價來自商店的商品頁面。
GPT-6 Luna引用一家線上酒類商店。GPT-6.1 Sol引用三家商店,包括高島屋。Grok 4.7引用一則Yahoo Shopping的商品頁面。GPT-6 Luna與Grok 4.7都寫到,它們找到的價格並不是市場平均價。
Grok 4.7搜尋得最廣,也寫得最多。
它以英文2,822字引用了14個網站。其他三則回答的篇幅是英文1,024至1,408字。
每則回答與它的數字。
| 模型 | 設定 | 提問日期 | 字數(英文) | 網站數 | 連結數 |
|---|---|---|---|---|---|
| GPT-6 Luna英文 | Max | 2026年10月9日 | 1,024 | 5 | 9 |
| GPT-6.1 Sol英文 | Max | 2026年10月9日 | 1,408 | 10 | 18 |
| Grok 4.7英文 | Fast | 2026年10月9日 | 2,822 | 14 | 24 |
| Qwen3.7-Plus英文 | Thinking | 2026年10月9日 | 1,216 | – |