面對展會口譯員的問題,哪個AI模型的網路搜尋做得更好?
我們在開啟網路搜尋的情況下,向三個OpenAI模型提出同一個問題,並使用不同的推理強度設定。本頁衡量每則回答搜尋的範圍有多廣,以及它引用的網頁是否支持它所寫的內容。本頁比較的是模型本身,而不是它們給的建議。
照原文逐字呈現。
research the effectiveness of the translators at a booth of a trade show in Japan. the goal is to understand how far we can go, and the limitation of the translation especially the below points to get smooth communication with visitors.
- language barrier
- product knowledge
Instruction
- $d-search
研究日本展會攤位上翻譯人員的效果。目標是了解我們能做到什麼程度,以及翻譯的限制,特別是以下幾點,好讓我們和參觀者順利溝通。
- 語言障礙
- 產品知識
指示
- $d-search
「$d-search」指示模型遵循Dorado的研究指示,這些指示要求使用第一手資料來源,並把每個主張與它自己的連結比對。這個問題需要很少人公開的資料來源:展會口譯員的服務條件、日文的參展商指南,以及翻譯工具的說明文件。這項測試看的是模型能否找到這些網頁,並且不超出網頁所寫的範圍。
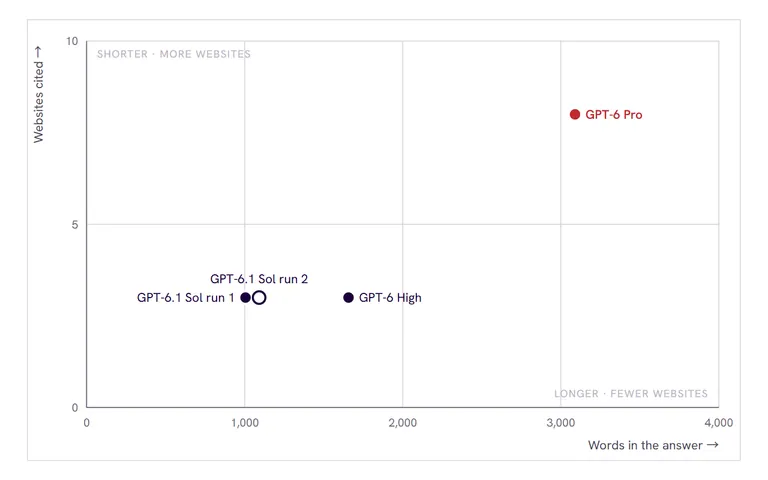
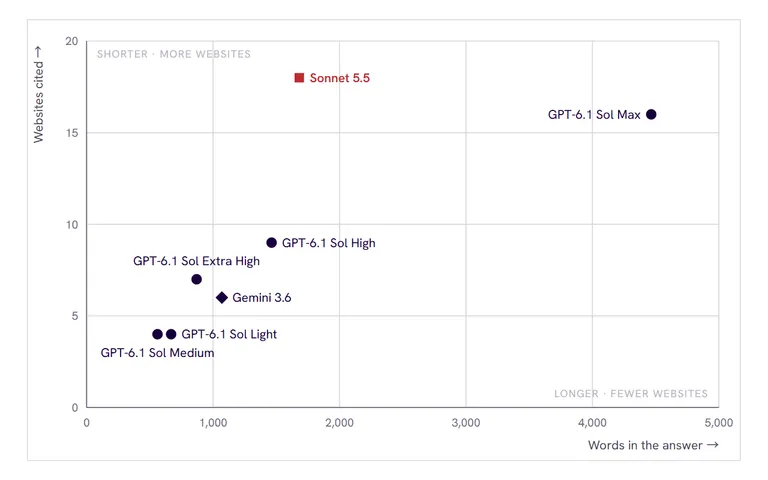
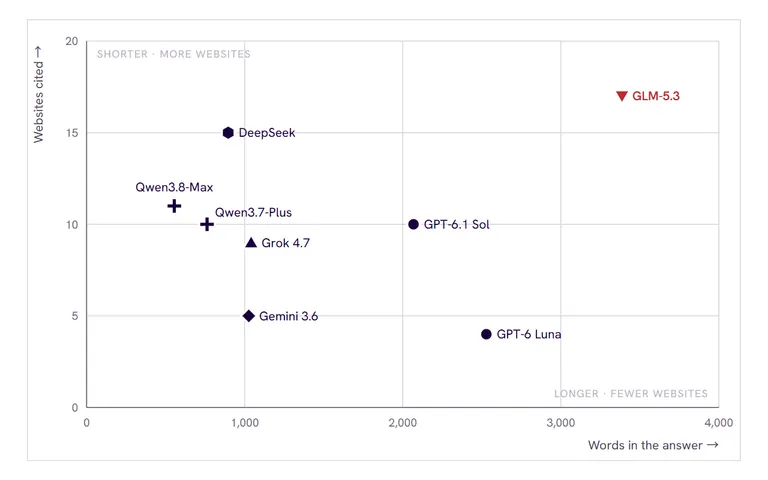
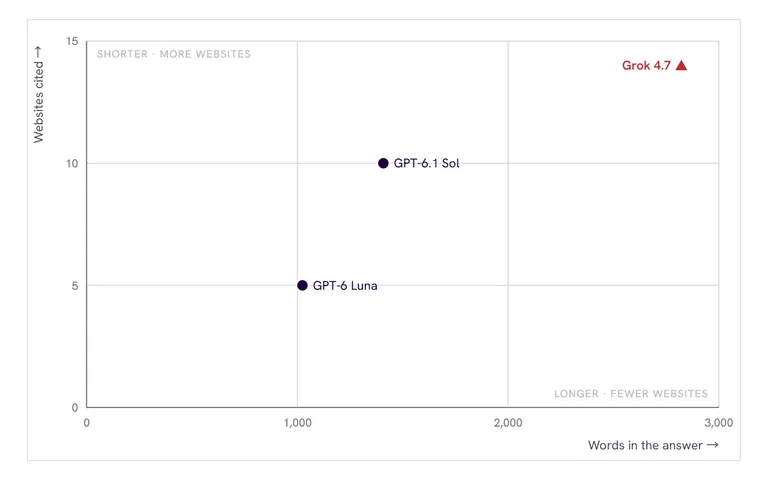
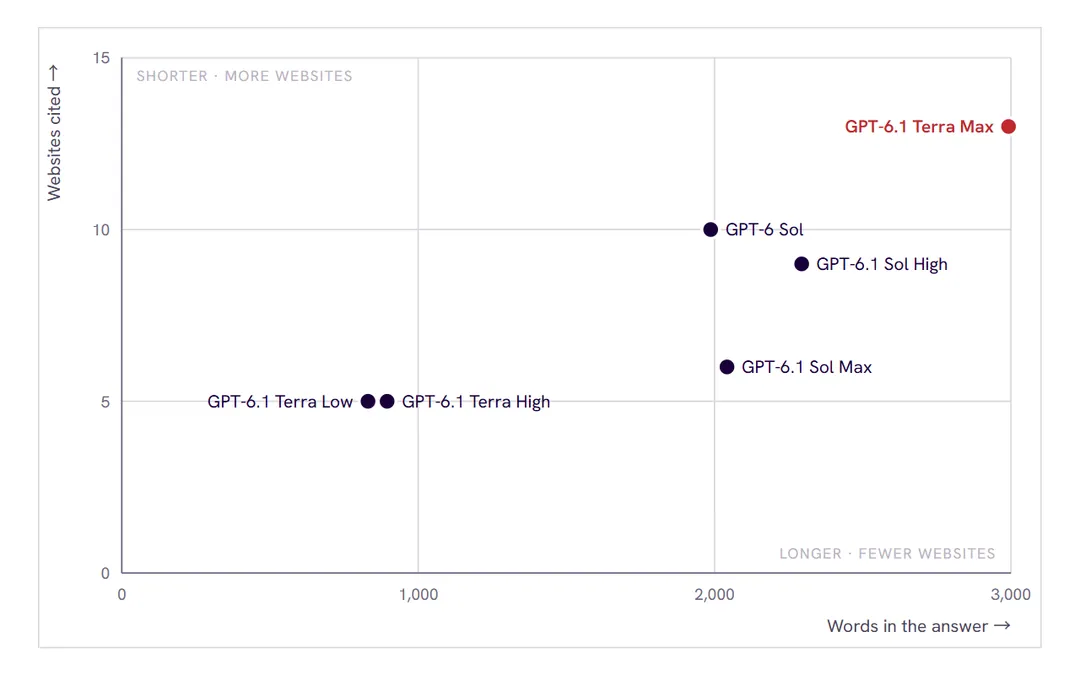
哪個模型搜尋得更深入?
以表格顯示
| 回答 | 字數(英文) | 引用網站數 |
|---|
引用的網站越多,代表模型搜尋得越廣,但不代表回答正確。下一張圖表會檢查這一點。
哪則回答照原文就站得住腳?
我們打開了每個引用連結,並將網頁與引用它的段落比對。段落中的每個數字、名稱、日期與條件都出現在網頁上,才算有依據。
檢查發現的問題
- GPT-6.1 Terra(High):失效連結。它引用的資料來源談的是2017年富山的一場展會,當時一位口譯員同時服務兩個攤位;這個網頁現在會轉址到無關的頁面。GPT-6.1 Terra(Low)引用的一份JETRO規定中,也有同樣的安排。
- GPT-6.1 Terra(Max):網頁遭封鎖。有兩段引用一份JETRO研討會的PDF,這份檔案拒絕所有存取請求。其中一段是在30秒內介紹產品的建議,這段沒有其他經過檢查的資料來源。
- GPT-6.1 Sol(High):產品不對。它把一個網頁稱為Pocketalk S的支援頁面。但網頁內文描述的是初代Pocketalk,內容截至2019年2月。
- GPT-6 Sol(Max):修飾過的引文。它引用VoiceTra的常見問題時,修正了一個拼字錯誤,卻沒有說明。它所支持的論點仍然成立。
用AI做研究時,這對選擇模型代表什麼。
研究指示發揮了大部分的作用。
每則回答都使用相同的研究指示,要求模型把每個主張與它自己的連結比對。107段引用內容中有102段完全站得住腳,也沒有任何網頁與它的段落相矛盾。
提高推理強度,換來的是廣度,不是準確度。
GPT-6.1 Terra(Low)以英文857字引用了5個網站。在Max設定下,它以英文2,992字引用了13個網站。兩者幾乎都完全站得住腳。較長的回答涵蓋了更多面向,例如翻譯App,而且同樣嚴謹。
有依據的段落,不等於有力的證據。
這些回答都指出,沒有任何研究衡量過日本展會攤位上口譯的準確度或銷售成效。它們的人力配置表和演練計畫是模型自己的建議,沒有附連結。這項檢查確認的是網頁上寫了什麼,而不是這些建議在您的攤位上是否有效。
活動網頁會消失。
參展手冊和研討會講義在展會結束後會搬移或關閉。32個引用的網頁中,有兩個我們已經打不開。您依賴的任何網頁,都請保留一份副本。
每則回答與它的數字。
| 模型 | 設定 | 字數(英文) | 網站數 | 已檢查段落 | 有依據 | 部分有依據 | 無依據 |
|---|---|---|---|---|---|---|---|
| GPT-6.1 Sol英文 | High | 2,294 | 9 | 23 | 22 | 1 | 0 |
| GPT-6.1 Sol英文 | Max | 2,042 | 6 | 14 | 14 | 0 | 0 |
| GPT-6 Sol英文 | Max | 1,987 | 10 | 26 | 25 | 1 | 0 |
| GPT-6.1 Terra英文 | Low | 857 | 5 | 7 | 7 | 0 | 0 |
| GPT-6.1 Terra英文 | High | 869 | 5 | 6 | 5 | 0 | 1 |
| GPT-6.1 Terra英文 | Max | 2,992 | 13 | 31 | 29 | 0 | 2 |