面對日本群眾募資成本的問題,哪個AI模型的網路搜尋做得更好?
我們向九個AI模型提出同一個問題,每個模型保留一則回答。紀錄顯示九個模型中有八個開啟了網路搜尋,Grok 4.7的紀錄則沒有註明。本頁計算每則回答引用了多少網站。我們沒有打開這些連結,因此無法判斷網頁內容是否支持回答所寫的內容。本頁比較的是模型本身,而不是它們給的建議。
照原文逐字呈現。
What are the top 5 crowd funding channel for overseas food providers in Japan.
We have limited budget, but we want to do more than testing.
My goal here is not to compare superficial price and functions, but I want to compare the total cost of 6-12 months project including creatives, ads, and commissions to the channels if exists.
Output condition
- Include fact links after the paragraph or sentence
對海外食品業者來說,日本前5大的群眾募資管道是哪些。
我們的預算有限,但想做的不只是測試。
我的目標不是比較表面上的價格和功能,而是想比較6-12個月專案的總成本,包括創意素材、廣告,以及付給各管道的手續費(如果有的話)。
輸出條件
- 在段落或句子後面附上事實來源連結
這個問題問的是6至12個月專案的總成本,包括創意素材、廣告和手續費,而不是表面上的收費標準。平台費用刊登在日文網頁上,並且會依方案而不同;公開創意素材與廣告成本的資料來源也很少。這項測試看的是模型能否找到費用頁面,並說明其他數字從何而來。
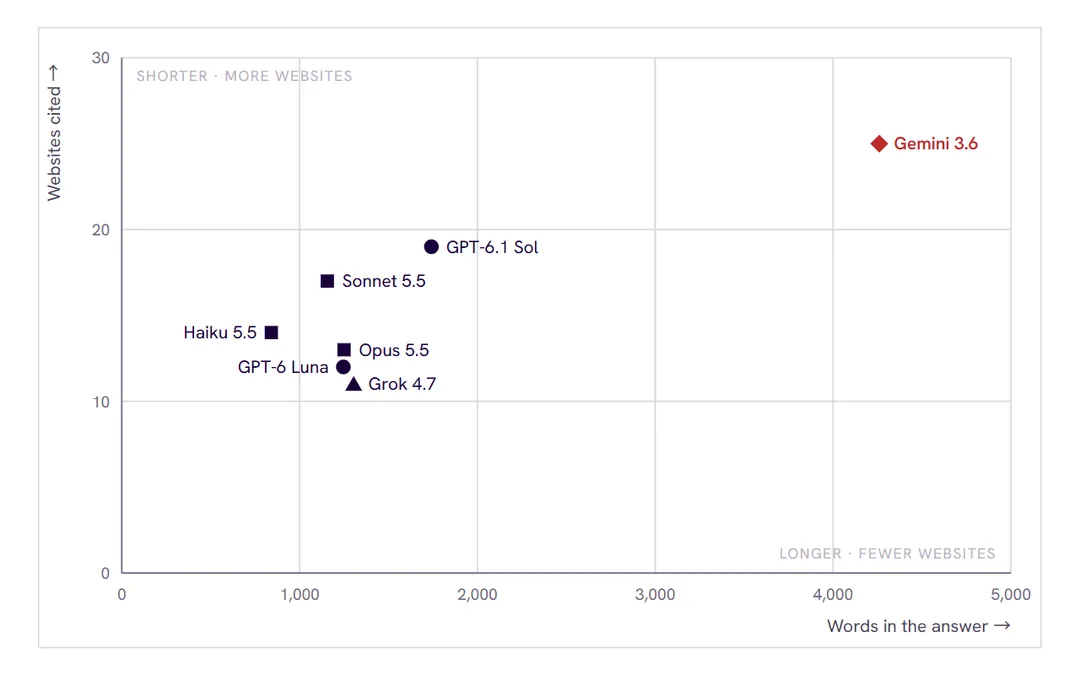
哪個模型搜尋得更深入?
以表格顯示
| 回答 | 字數(英文) | 引用網站數 |
|---|
引用的網站越多,代表模型搜尋得越廣,但不代表回答正確。這需要下方的連結檢查,而這個問題的檢查還沒有進行。
引用的網頁是否支持模型所寫的內容?尚未檢查。
在已檢查的比較中,我們會打開每個引用連結,並將網頁與引用它的段落比對。這個問題還沒有做這項檢查。下方數字顯示需要檢查的量。
引用連結 · 每個連結一個方格,尚未打開任何連結
在檢查完成之前,請把這些回答中的每個數字都當作線索,而不是事實。數字放進您的計畫之前,請先打開網頁確認。想看看完成的檢查是什麼樣子,請閱讀這項比較:口譯員與翻譯工具在展會攤位上的效果如何。
用AI做研究時,這對選擇模型代表什麼。
各回答的候選名單有所重疊。
九份五大管道名單中都有Makuake和CAMPFIRE。Kibidango和GREEN FUNDING出現在八份名單中,READYFOR出現在六份。Kickstarter Japan出現在兩份。Indiegogo Japan、machi-ya和Saki ni Tabetai各出現在一份。
各回答的成本總額不在同一個基準上。
這個問題要求的是6至12個月專案的總成本。每則回答都以自己假設的募資金額來計算總額。GPT-6 Luna、GPT-6.1 Sol、Sonnet 5.5和Haiku 5.5假設募得300萬日圓。Opus 5.5假設進行兩檔募資,每檔300萬日圓。Gemini 3.6和Grok 4.7假設500萬日圓,Qwen3.8-Max則假設1,000萬日圓。Qwen3.8-Omni-Flash以500萬日圓比較各管道,並在最後的預算中以300萬至500萬日圓的募資金額加總。Sonnet 5.5、Haiku 5.5和Opus 5.5都把自己的成本表標示為自行估算。
有兩則回答沒有提供連結。
Qwen3.8-Max把資料來源寫在括號中,例如「gourmetpro.co, 2024-08-04」,並在程式碼區塊中列出五個平台網址。它的括號引用中有三則寫的是aireportlibrary.com,也就是存放這些回答的知識庫。Qwen3.8-Omni-Flash沒有提供連結,也沒有資料來源清單。
最長的回答,搜尋範圍也最廣。
Gemini 3.6寫了4,260字,是第二長回答(GPT-6.1 Sol,1,741字)的兩倍多,引用了25個網站,Sol則是19個。它以編號引用,並在文末列出標題與網址清單。
每則回答與它的數字。
| 模型 | 設定 | 提問日期 | 字數(英文) | 網站數 | 連結數 |
|---|---|---|---|---|---|
| Opus 5.5英文 | Medium | 2026年10月8日 | 1,250 | 13 | 13 |
| Sonnet 5.5英文 | Medium | 2026年10月8日 | 1,156 | 17 | 17 |
| GPT-6 Luna英文 | Max | 2026年10月8日 | 1,246 | 12 | 13 |
| GPT-6.1 Sol英文 | Max | 2026年10月8日 | 1,741 | 19 | 27 |
| Gemini 3.6英文 | Thinking | 2026年10月8日 | 4,260 | 25 | 30 |
| Grok 4.7英文 | Fast | 2026年10月8日 | 1,304 | 11 | 16 |
| Qwen3.8-Max英文 | Thinking | 2026年10月8日 | 1,134 | – | |
| Qwen3.8-Omni-Flash英文 | Thinking | 2026年10月8日 | 1,661 | – | |
| Haiku 5.5英文 | Extra | 2026年10月8日 | 841 | 14 | 16 |