面對日本日常食品需求的問題,哪個AI模型的網路搜尋做得更好?
我們向五個AI模型提出同一個問題,每個模型保留一則回答。五個模型中,有四個的紀錄顯示開啟了網路搜尋。Grok 4.7的紀錄沒有註明。本頁計算每則回答引用了多少網站。我們沒有打開這些連結,因此無法判斷網頁內容是否支持回答所寫的內容。本頁比較的是模型本身,而不是它們給的建議。
照原文逐字呈現。
Research Japanese daily food demand? Not a fad, but food product or spices that blend into the daily life in Japan, so that the demand becomes constant.
If it's hard to find as solid fact, change the angle to search the actual cases that became a daily use/consumption food.
My goal here is to identify the long tail demand or cases, so that I can integrate those insights into our strategy planning of the product.
Output condition
- Include fact links after the paragraph or sentence
研究日本的日常食品需求?不是一時的流行,而是融入日本日常生活的食品產品或香料,讓需求變得穩定。
如果很難找到可靠的事實,就換個角度,搜尋實際成為日常使用/消費食品的案例。
我在這裡的目標是找出長尾需求或案例,好把這些洞察整合到我們產品的策略規劃中。
輸出條件
- 在段落或句子後面附上事實來源連結
這個問題要的是人們每天購買的食品與香料,而不是一時的流行,並允許在難以找到可靠數字時,改找實際案例。許多資料,例如家計調查和貿易統計,都以日文公布。這項測試看的是模型在改找案例之前,搜尋得有多廣。
哪個模型搜尋得更深入?
以表格顯示
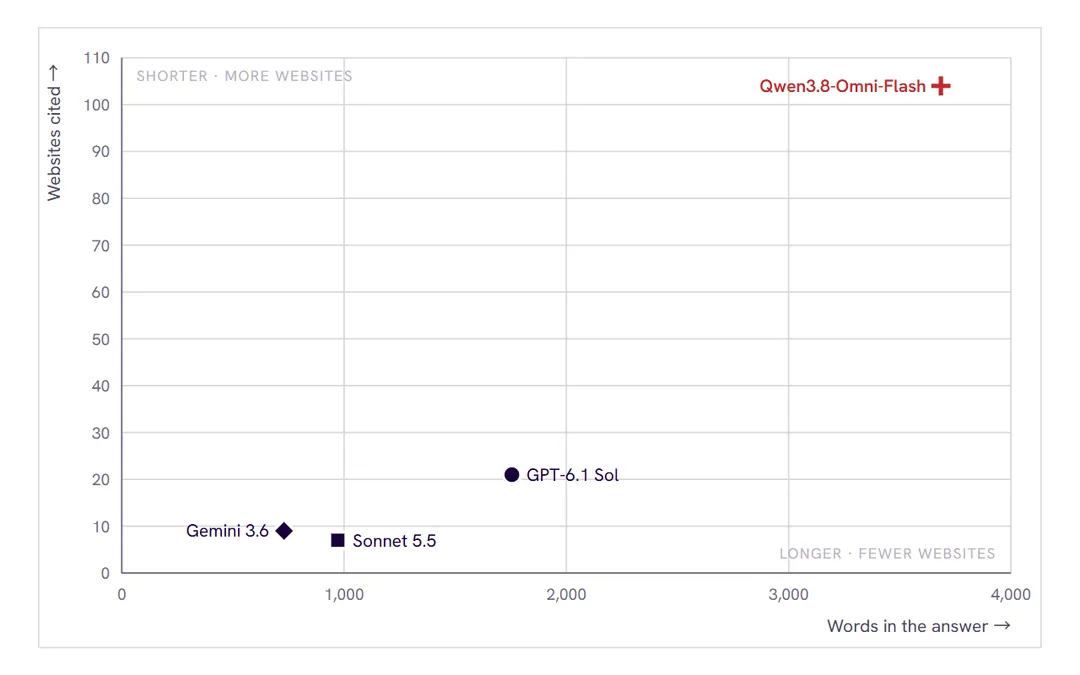
| 回答 | 字數(英文) | 引用網站數 |
|---|
引用的網站越多,代表模型搜尋得越廣,但不代表回答正確。這需要下方的連結檢查,而這個問題的檢查還沒有進行。
引用的網頁是否支持模型所寫的內容?尚未檢查。
在已檢查的比較中,我們會打開每個引用連結,並將網頁與引用它的段落比對。這個問題還沒有做這項檢查。下方數字顯示需要檢查的量。
引用連結 · 每個連結一個方格,尚未打開任何連結
在檢查完成之前,請把這些回答中的每個數字都當作線索,而不是事實。數字放進您的計畫之前,請先打開網頁確認。想看看完成的檢查是什麼樣子,請閱讀這項比較:口譯員與翻譯工具在展會攤位上的效果如何。
用AI做研究時,這對選擇模型代表什麼。
有一則回答引用的網站數,約是第二名的五倍。
Qwen3.8-Omni-Flash以英文3,685字引用了104個網站。GPT-6.1 Sol以21個居次。Qwen3.8-Omni-Flash把資料來源寫成括號裡的網址,並把許多來源的用語和數字保留為日文。
有兩則回答指出,日常需求並沒有以單一數字公布。
Sonnet 5.5說可靠的統計資料很少,於是依照問題允許的方式改找案例。Qwen3.8-Omni-Flash說它用三項替代指標重新推算這個數字:每人供給量、人們食用這項食品的頻率,以及持續創新高的品類銷售額。
每則回答挑選的案例都不同。
Gemini 3.6以四種調味料為基礎:「食べるラー油」、麵味露、鹽麴和柚子胡椒。Grok 4.7從丘比美乃滋、咖哩塊和香鬆談起。GPT-6.1 Sol從一項納豆調查談起,接著談到韓式泡菜。
連結的缺漏各不相同。
Grok 4.7沒有任何連結,儘管問題要求在每個段落或句子後面附上連結。Gemini 3.6有十個連結,其中一個是google.com的搜尋網址,裡面包著一個thefermentary.com的網址。
每則回答與它的數字。
| 模型 | 設定 | 提問日期 | 字數(英文) | 網站數 | 連結數 |
|---|---|---|---|---|---|
| Sonnet 5.5英文 | Medium | 2026年10月7日 | 972 | 7 | 14 |
| GPT-6.1 Sol英文 | Max | 2026年10月7日 | 1,755 | 21 | 27 |
| Gemini 3.6英文 | Thinking | 2026年10月7日 | 730 | 9 | 10 |
| Grok 4.7英文 | Fast | 2026年10月7日 | 914 | – | |
| Qwen3.8-Omni-Flash英文 | Thinking | 2026年10月7日 | 3,685 | 104 | 147 |